1
0
0
关于隐私,我最近想明白的一点
文章摘要
|
用得越多,我越经常被问到一个问题:你把这些东西发给 AI,不怕泄露吗?
说实话,我一开始的态度是两极的:要么完全不在意,要么干脆什么都不用。最近我想明白了一点,中间态才是正常的。
我最初的两个极端
第一个极端:不在意。刚开始用的时候,我什么都往里贴 —— 工作文档、代码、聊天记录。当时想的是「反正也没人看」。
第二个极端:什么都不发。后来看到一些讨论,我又变得很紧张,连写个周报都不敢用。结果是我把工具的价值全丢了。
我现在的做法:按材料分级
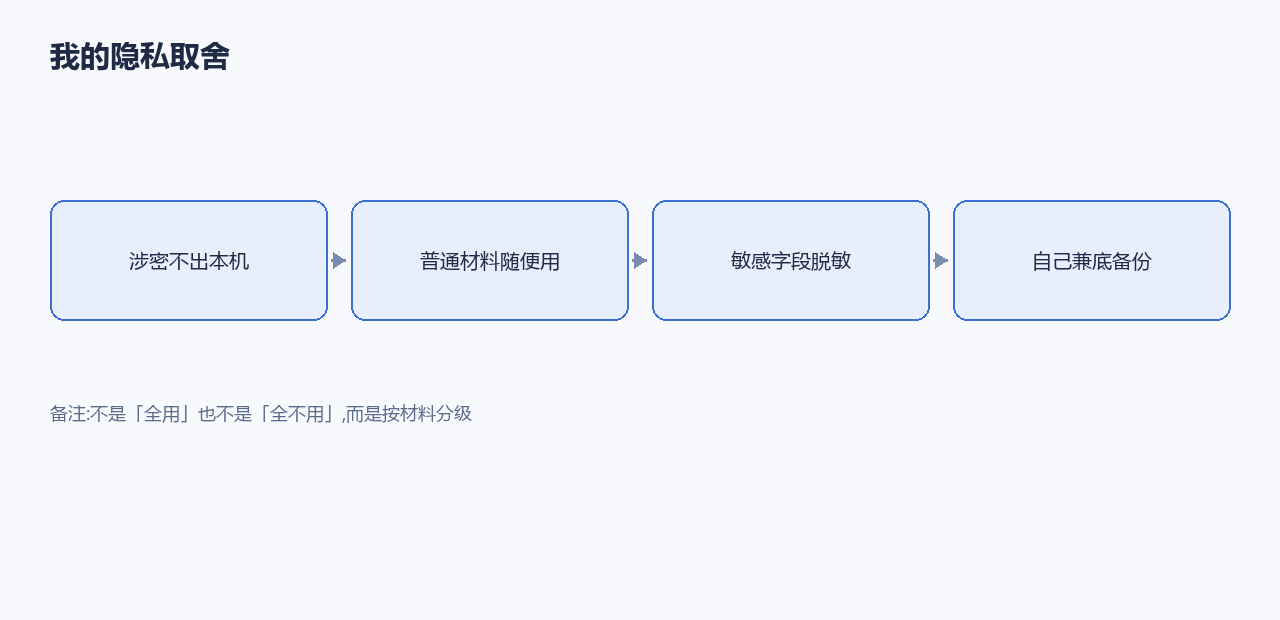
图 1:我现在的隐私取舍
我把手上的材料分成四类,处理方式完全不同:
第一类:绝对不能出的。任何真实凭据(密码、密钥、身份证件)、别人的隐私信息。这类东西我连本地模型都不一定喂,更不会发出去。
第二类:敏感但可脱敏的。比如带真实数据的报表。我的做法是先把敏感字段换掉再处理 —— 名字换成代号,数字按比例缩放,处理完再换回去。
第三类:工作 / 学习材料。这类我正常用,但会避开具体的公司名、人名、项目代号。
第四类:公开信息。新闻、文档、开源代码 —— 随便用,没有任何顾虑。
我自己守的三条底线
- 凭据永不出本机。这条没有例外,再方便也不发。
- 别人的信息我不替人做主。涉及他人的信息,我不往任何第三方发。
- 重要材料本地留底。无论用不用 AI,原始文件我都自己存一份 —— 不把「数据在哪」这件事交给别人决定。
我的结论
我现在的想法是:隐私这事不能靠「一刀切」来解决。
全都不发,等于放弃工具;全都发出去,等于放弃底线。真正要练的是一种能力:判断手上这份东西属于哪一类,然后选对应的做法。
这个判断练熟了之后,我用 AI 反而更自在了 —— 因为我知道自己在做什么,也知道风险在哪。