1
0
0
在小机器上跑模型:能干什么,不能干什么
文章摘要
|
前阵子我在自己的机器上跑了一个本地模型。动机很朴素:有些材料不方便传出去,而且不用给钱。跑了半个多月,我大概摸清了它的边界,这篇说说我的真实感受。
我为什么要在本地跑
三个理由,按重要性排序:
- 隐私:有些东西我不想发给任何第三方
- 稳定:不依赖网络,不怕服务挂了或者限流
- 顺手:随时可用,不用等
我主要让它干四件事
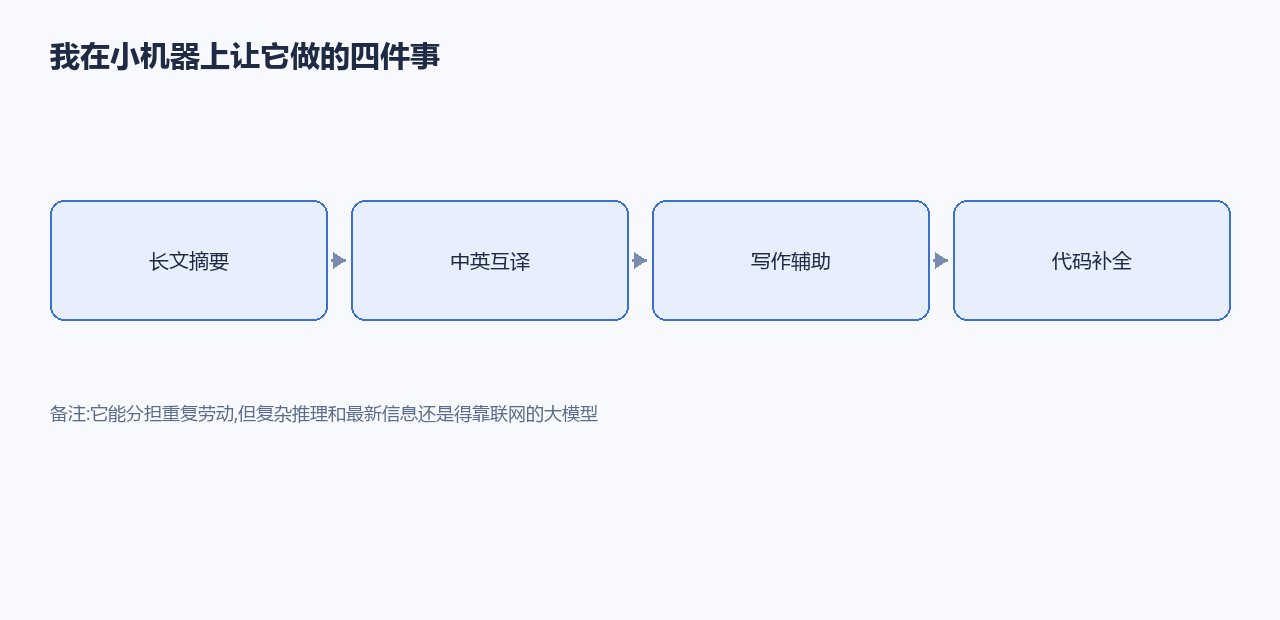
图 1:我主要让它干的四件事
这四件事有个共同点:都是「有明确答案」的重复劳动。
- 长文摘要:把一篇几千字的文章压缩成要点,它做得比我快
- 中英互译:日常材料的翻译够用了,专业术语还是会有偏差
- 写作辅助:帮我改病句、调语气,但不指望它写出观点
- 代码补全:补全小函数、写测试模板都很顺手
它明显干不好的事
- 长文档的记忆。材料一长,前面说的后面就忘。
- 最新信息。它不知道这个月发生了什么,问它新东西很容易一本正经地编。
- 复杂推理。多步骤的逻辑题,它常常中途跑偏,而且错得很自信。
- 多轮任务的连贯性。来回改几轮之后,它会把早先说好的约束丢掉。
我现在的用法:分工
- 涉密 / 私人的材料 → 本地模型处理,哪怕慢一点、笨一点
- 要最新信息 / 复杂任务 → 联网的大模型
- 重复的体力活(摘要、翻译、格式化) → 两个都行,谁快用谁
我的结论
本地模型给我最大的感受不是「它有多强」,而是它让我对「什么时候不该用 AI」有了更清楚的认识。
知道它的边界之后,我反而用得更踏实了:该它干的交给它,不该它干的别硬塞。这大概比追最新模型更有用。